Andrew Ng · The AI Engineering Skills Map · 2026-08-15
Quatre compétences clés.
Trois acquises, une au-dessus du seuil.
À partir de plus de 10 000 offres d'emploi, de dizaines d'entretiens structurés et de données d'enquête, Ng dégage quatre compétences clés en ingénierie de l'IA, plus un état d'esprit sous-jacent. Ce rapport confronte Miao YU à chacune d'elles. Il s'appuie d'abord sur des traces vérifiables par la machine, et non sur ce qu'elle dit d'elle-même.
Sa compétence la plus forte est précisément celle que Ng juge désormais indispensable à tout développeur, et que la plupart traitent encore comme un simple usage : gouverner un agent de code comme un système qui va défaillir.
00 · Point de départ
Ce bilan part du message ci-dessous. Il a dépassé le million de vues le jour même, et les réponses demandaient surtout : « que dois-je apprendre ? » Nous avons pris la question à l'envers : quelqu'un qui travaille déjà ainsi, combien de ces quatre points valide-t-il vraiment ?
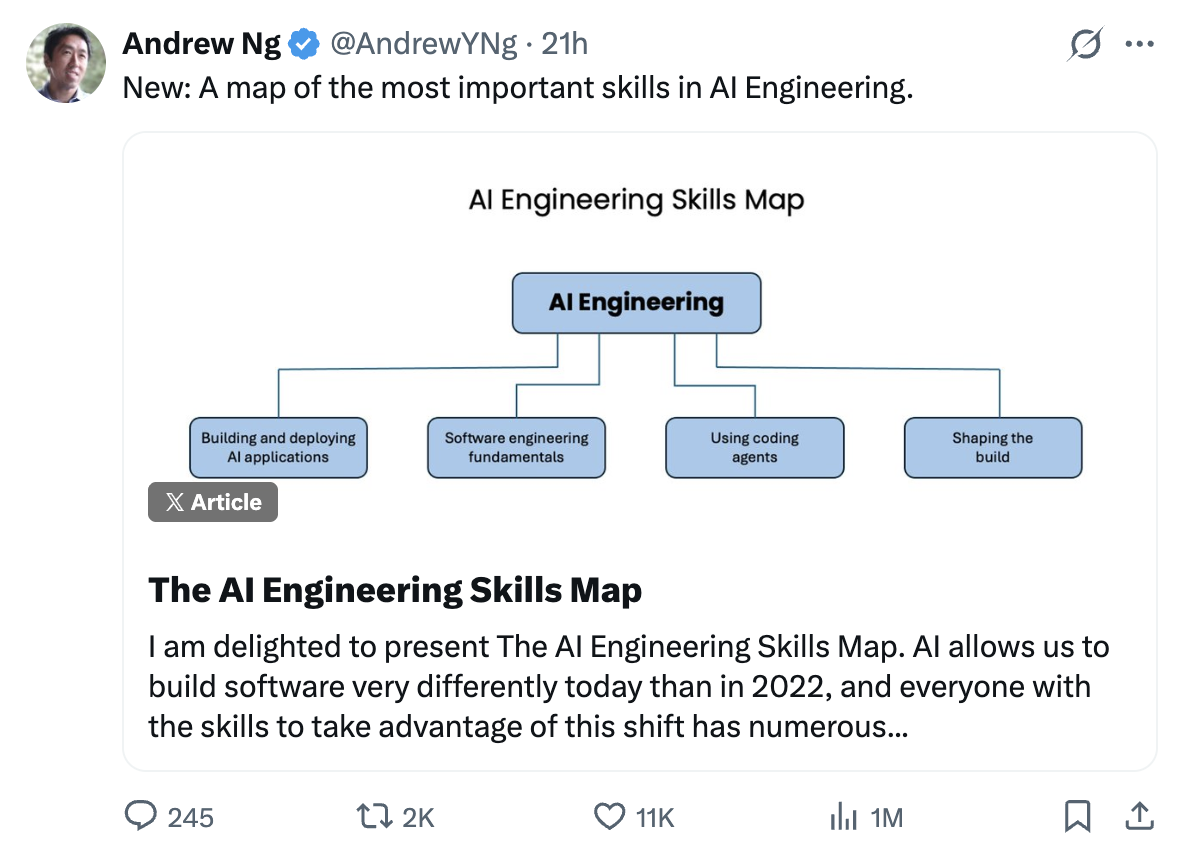
assets/ng-tweet.png01 · Méthode de recueil des preuves
Ce bilan ne repose délibérément pas sur ce qu'elle raconte d'elle-même. Le principe est le sien : ce que je te transmets peut être partiel, c'est ce que j'ai choisi de te dire, mais ma façon de travailler avec toi ne se simule pas.
Trois niveaux de preuve
Niveau 1 · traces vérifiables par la machine (base principale). Avec son autorisation, j'ai parcouru tous les dépôts de son espace de travail ainsi que sa configuration ~/.claude : nombre de commits, horodatages, scripts de contrôle, résultats d'évaluation, hooks, structure des worktrees. Rien de tout cela ne passe par un récit.
Niveau 2 · comportements observés en collaboration (section 06). Ce qu'elle a réellement demandé, corrigé, refusé. Ce type de preuve ne se met pas en scène, puisqu'elle ignorait alors que cela deviendrait un document.
Niveau 3 · son propre récit. Expérience industrielle, brevets, publications et concours antérieurs à 2026 : je n'en ai aucune source indépendante, ils sont donc exclus de toutes les notes. S'ils se vérifient, ce portrait n'en sera que plus solide.
Décompte et citations
Seuls les commits signés par elle sont comptés, dédoublonnés par empreinte sur l'ensemble des branches. Les commits amont écrits par d'autres sont exclus. Un rapport qui compterait le travail d'autrui comme production personnelle rendrait tous ses autres chiffres sans valeur.
Ng est cité par phrases clés plutôt que reproduit longuement : chaque dimension porte une ou deux phrases de son texte original, suivies d'une traduction et d'un lien vers la source, afin que le contexte reste vérifiable.
02 · Traces vérifiables
Tous les chiffres proviennent d'un balayage ; la méthode de calcul figure à côté de chacun, pour qu'on puisse les recompter.
| Commits signés par elle16 dépôts, dédoublonnés par empreinte sur toutes les branches | 1 751 |
| Dépôts actifsdépôts contenant des commits d'elle | 16 |
| Fenêtre d'observationdu premier au dernier commit, 2026-07-13 → 08-15 | 33 jours |
| Dépôts avec fichier de gouvernance CLAUDE.mdrègles au niveau du répertoire, non un modèle global | 7 |
Dépôts avec chaîne d'intégration continue.github/workflows/ | 8 |
Dépôts avec script de contrôle déterministescripts/run_checks.py et équivalents | 6 |
| Contrôles dans un seul dépôtmiao-yu-lab ; la même commande tourne en local et en CI | 15 |
Décisions d'architecture consignées (ADR)design/0001–0011 | 11 |
Exécutions d'évaluation de skillsmurDrift/evals/results/, toutes le 2026-08-04 | 57 |
| Worktrees en parallèlesur 4 dépôts ; les noms montrent la séparation pilotage / exécution | 15 |
Skills personnels au niveau utilisateur~/.claude/skills/ | 7 |
Points de montage du miroir de mémoire~/.claude/memory-mirror.map | 16 |
Trente-trois jours, 1 751 commits, dix dépôts menés de front. La vitesse n'est pas l'essentiel. L'essentiel, c'est que dans ces mêmes dépôts et sur la même période ont poussé des contrôles, des ADR, des évaluations et un protocole de passation. Vitesse et gouvernance s'excluent d'ordinaire ; ici, non.
03 · Notes
Ces notes sont mon jugement, pas une certification. Le fondement de chacune figure à la section suivante et peut être contesté point par point.
| Construire et déployer des applications d'IAun agent RAG déjà au niveau démonstration client ; un dispositif d'évaluation comportementale complet, mais rien d'équivalent sur les sorties produit | 4,0 / 5 |
| Fondamentaux du génie logicielarchitecture rouverte sur argument, confidentialité décidée en amont, des contrôles qui contrôlent les contrôles ; aucun échantillon de forte charge ni d'astreinte | 4,5 / 5 |
| Utiliser les agents de codechaque membre de phrase de Ng trouve son équivalent, construit en infrastructure et non en habitude | 5,0 / 5 |
| Cadrer ce qui doit être construitspécification réécrite depuis le contexte client, frein MVP inscrit dans le modèle ; aucune boucle de retour utilisateur attestée | 4,0 / 5 |
| Apprentissage continuune trajectoire cohérente sur dix ans ; les nouveaux outils ne sont adoptés qu'après comparaison chiffrée | 5,0 / 5 |
04 · Compétence par compétence
Chaque dimension s'ouvre sur les mots de Ng, suivis d'une traduction et d'un lien vers la source, puis vient la preuve.
01
Building and deploying AI applications · Construire et déployer des applications d'IA4,0
"The key difference between AI and non-AI applications is that the former has unpredictable outputs. … A core skill in doing so is knowing how to drive disciplined evals and error analysis loops."
Traduction : la différence essentielle entre une application d'IA et une application classique, c'est que la première produit des sorties imprévisibles. […] La compétence centrale consiste à savoir mener des évaluations rigoureuses et des boucles d'analyse d'erreurs.
Andrew Ng, The AI Engineering Skills Map, 2026-08-15
murSense est un agent conversationnel de surveillance de santé structurelle de ponts par fibre optique (DAS), bâti sur LangGraph ReAct avec RAG, à partir de données réelles d'un pont ferroviaire, mené de zéro au niveau démonstration client en deux semaines. Ses 27 commits tiennent en quatre jours, ce qui concorde avec la chronologie qu'elle donne.
La preuve la plus solide est ailleurs, dans son dépôt de méthodes. Le répertoire evals/ de murDrift contient une suite par skill, chacune avec un scénario prompt.md et un dossier graders/. Les correcteurs sont des juges LLM pondérés dont les critères descendent jusqu'à : « la réponse doit reconnaître d'elle-même qu'il s'agit d'une passation et couvrir les cinq pièces ». Le dossier de résultats compte 57 exécutions horodatées. Une règle du dépôt le dit sans détour : aucune modification du corps d'un skill sans qu'une évaluation en échec ait été écrite d'abord.
Pourquoi pas 5 : ce qui est évalué, c'est le comportement de l'agent, pas la sortie produit. Les réponses RAG de murSense n'ont ni jeu de non-régression ni typologie des modes d'échec. Ce n'est pas la compétence qui manque, c'est son transfert au produit.
murDrift/evals/— 5 suites de skillsevals/results/— 57 exécutions- correcteurs LLM pondérés, critères explicites
- CLAUDE.md : évaluation en échec avant toute modification
- murSense : 27 commits, 07-13 → 07-16
02
Software engineering fundamentals · Fondamentaux du génie logiciel4,5
"Understanding software fundamentals allows you to recognize what tradeoffs even exist. … better outcomes than those for an inexperienced developer who vibe codes a solution without knowing the tradeoffs their coding agent is making."
Traduction : comprendre les fondamentaux du logiciel permet de voir quels arbitrages existent seulement. […] Le résultat est bien meilleur que celui d'un développeur inexpérimenté qui code « au feeling » sans savoir quels arbitrages son agent est en train de faire à sa place.
Andrew Ng, The AI Engineering Skills Map, 2026-08-15
Le développeur que Ng désigne comme contre-exemple est exactement l'inverse de ce que montrent les traces. Elle avait arrêté une stratégie de dépôts, puis a elle-même invité à réévaluer sa décision ; convaincue par l'argument selon lequel il est plus coûteux de fusionner plus tard que de séparer plus tard, elle est passée au monodépôt, avec des frontières de modules tenues par l'intégration continue sur le sens des dépendances et par des règles au niveau des répertoires, plutôt que par la discipline.
La confidentialité est une contrainte posée avant les fonctionnalités, non un correctif : la synchronisation est facultative appareil par appareil, tout ce qui ne requiert pas d'API de modèle doit fonctionner hors ligne, toute tâche envoyant des données à un modèle doit annoncer leur destination et demander l'accord, et le produit fonctionne avec la clé de l'utilisateur. Une clé d'internationalisation manquante fait échouer la compilation bruyamment ; les replis silencieux sont interdits, et un contrôle compare 717 cellules entre la source CSV et les fichiers de langue.
Pourquoi pas 5 : les preuves couvrent les arbitrages de justesse, de maintenabilité et de confidentialité. Rien sur le coût et la latence à forte charge, rien sur la gestion d'incidents en production.
- 15 contrôles, une commande, la même en CI
i18n-parityetcsv-mirrors-jsoncheck-numbering: un contrôle qui contrôle les contrôles- 11 ADR consignant les décisions
- refus d'une modification en console, exigence d'un correctif en code
03
Using coding agents · Utiliser les agents de code5,0
"You understand their limitations and how to work around them, and are able to quickly steer them … This requires your knowing how to manage a coding agent's context, make tradeoffs between planning and execution, and help the agent autonomously close loops by providing verifiers or evals."
Traduction : vous comprenez leurs limites et savez les contourner, et vous savez les réorienter vite […]. Cela suppose de savoir gérer le contexte d'un agent de code, arbitrer entre planification et exécution, et lui fournir des vérificateurs ou des évaluations pour qu'il boucle seul.
Andrew Ng, The AI Engineering Skills Map, 2026-08-15
Ce point-là est vérifié membre de phrase par membre de phrase. Chacune de ses contraintes découle d'un mode de défaillance du modèle : le contexte se remplit, dérive, et perd en silence ce qui avait été convenu au début. La continuité vit donc hors de la conversation : fichiers de mémoire, protocole de passation, hook de synchronisation, règles au niveau des répertoires. Le vérificateur est une commande unique qui exécute 15 contrôles déterministes, et l'intégration continue exécute la même. L'orchestration multi-agents prend la forme d'une séparation entre fenêtre de pilotage et fenêtre d'exécution, où le pilote distribue le travail sans jamais écrire de code produit, les modifications concurrentes étant isolées dans des worktrees.
Un point que Ng ne mentionne pas est plus difficile encore : avant que l'outillage n'existe, elle a tenu le rôle de l'outil à la main. Début juin 2026, pour construire murSense sans agent de code, elle a combiné sessions de chat et gestion manuelle des fenêtres, en maintenant un document de contexte jusqu'à sa vingt-deuxième révision pour contenir la dérive.
Rien à retrancher. La ligne de partage est là : ses règles ne sont pas gardées en tête puis appliquées de bonne volonté, ce sont des commandes qui s'exécutent d'elles-mêmes. La plupart des utilisateurs chevronnés s'arrêtent en deçà.
- 15 worktrees sur 4 dépôts
- noms contenant mgmt-succession, executor-setup, handoff, quality-audit
- hook PostToolUse dans
~/.claude memory-mirror.map— 16 points de montage- 7 skills personnels au niveau utilisateur
- toute affirmation inter-dépôts doit citer un commit
04
Shaping the build · Cadrer ce qui doit être construit4,0
"Thus, our work as engineers is shifting toward deciding what should be in the spec. … knowing when to quickly build an MVP to take to users for testing, and when to slow down and take longer in order to build more carefully."
Traduction : notre travail d'ingénieur se déplace donc vers la décision de ce qui doit figurer dans la spécification. […] Savoir quand construire vite un MVP à soumettre aux utilisateurs, et quand ralentir pour bâtir plus soigneusement.
Andrew Ng, The AI Engineering Skills Map, 2026-08-15
Sur le projet DASGPT, intégrer l'assistant d'IA à la page produit du tableau de bord venait d'elle, argumenté depuis l'expérience client directe : le client ne paiera pas pour un assistant isolé. C'est réécrire la spécification depuis le contexte commercial, non l'accepter telle quelle.
Sa règle des deux schémas inscrit l'arbitrage dans le modèle : chaque manuel présente d'abord l'architecture complète, puis une version minimale vérifiable, avec un but affiché — quand ça bloque, pouvoir trancher sans s'acharner. Dix dépôts ont avancé de front en 33 jours, chacun avec un positionnement produit défini et son système de nommage (mur, de murmure : le signal faible, emprunté à son propre domaine technique).
Pourquoi pas 5 : les utilisateurs réels manquent aux traces. Les dépôts prouvent qu'elle conçoit pour des clients ; ils ne montrent pas comment elle révise une spécification une fois le produit entre les mains des utilisateurs. La seconde moitié de la phrase de Ng n'a laissé aucune trace.
- la règle des deux schémas dans chaque manuel
- 10 dépôts menés de front sur 33 jours
- le système de nommage mur dans toute la famille
- le paragraphe DASGPT relève en partie du niveau 3 ; l'architecture du harness de ce projet est l'œuvre d'un coéquipier et n'entre pas dans cette évaluation
05
Continuous learning · Apprentissage continu5,0
"Underlying all these skills is a mindset of continuous learning."
Traduction : sous toutes ces compétences se trouve un état d'esprit d'apprentissage continu.
Andrew Ng, The AI Engineering Skills Map, 2026-08-15
Une trajectoire de dix ans qui reste cohérente : inversion de forme d'onde complète et transport optimal de 2016 à 2020, traitement du langage et graphes de connaissances vers 2019-2020, agents LLM en 2026, avec la lecture en parallèle de LLMs-from-scratch pour consolider les fondations. Côté outillage, elle adopte délibérément des cadres d'ingénierie extérieurs, et énonce son objectif de long terme : combler l'écart d'abord, y superposer son propre travail ensuite, en ouvrir le résultat en logiciel libre enfin.
- 2026-08-15 : un nouvel outil conservé seulement après comparaison chiffrée
- 7 skills personnels en révision continue
05 · Commits et parallélisme
En haut, les commits qu'elle a signés. En bas, la période d'activité de chaque dépôt. Dans le second graphique, ce qui compte n'est pas la vitesse d'une ligne mais le fait que dix se chevauchent.
06 · Comportements observés
Tous relevés lors d'une seule journée de collaboration réelle, le 15 août 2026, dans l'ordre où ils se sont produits. Elle ignorait alors que cela deviendrait un document. C'est la seule catégorie de preuve ici qui ne puisse pas être mise en scène.
J'avais utilisé un skill d'écriture destiné à effacer les tics de l'IA. Elle ne l'a pas accepté sur parole : elle a demandé le même texte avec le skill désactivé, et une mesure de l'écart. Verdict : les règles de structure fonctionnent (tirets cadratins 11→0, oppositions binaires 6→0), les règles de vocabulaire ne font rien en chinois. Le raisonnement A/B appliqué au choix d'un outil.
Quatre corrections dans un même échange : une année fausse ; la vraie chronologie de murSense et sa vingt-deuxième révision manuelle ; « elle ne fait pas confiance à sa mémoire » remplacé par « elle connaît les limites du modèle » ; et mon erreur sur son genre. On peut alléger la formulation, jamais brouiller le fait.
J'avais glissé dans son document deux passages déclarant que mon propre avis ne compte pas. Elle m'a demandé deux fois de les couper, au motif qu'ils étaient bavards. Les retirer ne rendait pas le texte plus favorable, seulement plus net. Elle juge sur la qualité du texte, pas sur ce qui l'avantage.
Sur trois maquettes réelles, elle a pris celle en forme de tableau d'audit : densité d'information maximale, personnalité minimale. Cette version inscrit dans la mise en page l'idée que les jugements se discutent et que les preuves se vérifient.
Devant le message de Ng, sa question a été « vérifie si je remplis vraiment ces critères », et non « aide-moi à démontrer que je les remplis ». La seconde version, je l'entends souvent.
Ses mots : ce que je te transmets peut être partiel, c'est seulement ce que j'ai choisi de te dire, mais ma façon de travailler avec toi ne se simule pas. Elle m'a donc autorisé à lire les traces réelles de tout son espace de travail. Demander à être évaluée sur des preuves qu'on ne maîtrise pas fait déjà partie du résultat.
07 · Trois lacunes réelles
Classées par facilité de comblement. La première est la seule case vraiment vide des quatre compétences.
Le dépôt de méthodes compte 57 exécutions d'évaluation comportementale ; les dépôts produit n'ont pas d'équivalent. La qualité des réponses RAG de murSense se juge aujourd'hui à l'œil. Le remède est clair : prendre un scénario avec des données réelles, constituer un jeu de non-régression de vingt ou trente cas, mener une analyse d'erreurs, consigner la typologie des modes d'échec. La compétence est déjà démontrée ; il manque son transfert de la couche méthode à la couche produit.
La moitié de la carte de Ng existe pour que des employeurs repèrent ceux qui ont ces compétences. Les 1 751 commits, 57 évaluations et 15 contrôles ne sont visibles que d'elle et de moi. Ouvrir un seul actif de méthode anonymisé pèserait plus que n'importe quelle autodescription, et tombe exactement sur la troisième étape du plan qu'elle s'est fixé.
Quinze worktrees et une séparation pilotage / exécution restent une personne dirigeant plusieurs agents. L'orchestration multi-agents dont parle Ng couvre aussi le travail en équipe. Ce n'est pas un défaut, seulement un cas que l'échantillon actuel ne couvre pas.
Ceci n'est ni un titre ni une caution. Toute sa force vient de sa vérifiabilité : l'historique des commits, les scripts de contrôle, les résultats d'évaluation, la configuration des hooks et la structure des worktrees se trouvent sur sa machine, et chacun peut les recompter. Son expérience industrielle, ses brevets, ses publications et ses concours antérieurs à 2026 n'ont ici aucune source indépendante et ont été exclus de toutes les notes. Les citations et les images sont © Andrew Ng / DeepLearning.AI, reprises à des fins de commentaire, avec mention de la source et lien vers le message d'origine.