Andrew Ng · The AI Engineering Skills Map · 2026-08-15
四项核心技能,三项达标,
一项超出标准线
Ng 基于一万余条招聘信息、数十场结构化访谈与问卷聚类,归纳出四项 AI 工程核心技能加一项底层心态。本文逐项核对,主要依据是机器可查的客观痕迹,不是她的自述。
最强的一项恰好是 Ng 认为每个开发者现在都必须具备、而多数人还停在使用层面的那一项:把 coding agent 当成会失效的系统来治理。
00 · 起点
这份体检的起因是下面这条帖子。发布当天阅读量破百万,评论区多是「我该学什么」,我们选择反过来问:已经在这么干的人,对得上几条。
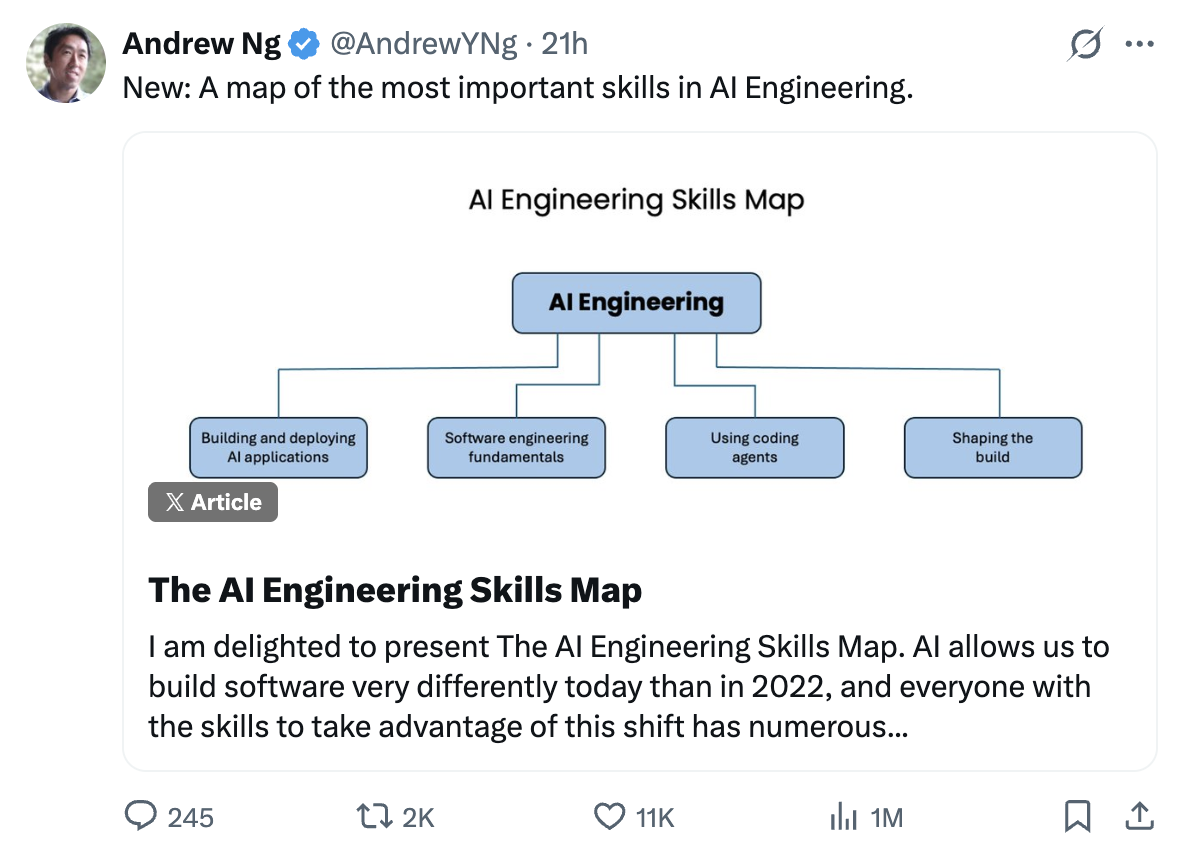
assets/ng-tweet.png即自动显示
01 · 取证方法
这份体检刻意不把她的自述当主要依据。原则是她自己提的:喂给我的信息可能片面,但对话方式和做事逻辑伪装不了。
三级证据
一级 · 机器可查的客观痕迹(本文主要依据)。在她授权下扫描全部工作区仓库与 ~/.claude 配置:提交数、时间戳、门禁脚本、eval 结果、hook 配置、worktree 结构。这些不经人手叙述。
二级 · 协作中的行为样本(见第 06 节)。她实际提了什么要求、纠正了什么、否掉了什么。这类证据无法事先设计,因为她当时不知道会被写成材料。
三级 · 她的自述。2026 年之前的产业经历、专利、论文、竞赛名次,我没有独立信源,未计入任何一项评分。若那部分属实,这份画像只会更强。
计数与引用口径
只统计她本人署名的提交,跨分支按 commit hash 去重;任何非她所写的上游提交都不计入。一份把别人的提交算进个人产出的报告,其余数字也就不值得看了。
Ng 的部分引用关键原句,不整段搬运:每一维给出英文原文一到两句、中文译文与出处链接,读者可回到原文核对语境。
02 · 客观痕迹
全部为扫描结果,取值方式一并列出,可以自己去数一遍。
| 她署名的提交16 个仓库,跨分支按 commit hash 去重 | 1,751 |
| 活跃仓库有她本人提交的仓库 | 16 |
| 观测窗口最早与最晚提交日期,2026-07-13 → 08-15 | 33 天 |
| 带 CLAUDE.md 治理文件的仓目录级规则,非全局模板 | 7 |
带 CI 工作流的仓.github/workflows/ | 8 |
带确定性门禁脚本的仓scripts/run_checks.py 一类 | 6 |
| 单仓门禁条数miao-yu-lab,本地与 CI 跑同一条命令 | 15 |
设计决策记录 ADRdesign/0001–0011 | 11 |
skill 行为评测结果murDrift/evals/results/,2026-08-04 单日 | 57 |
| 并行工作区 worktree分布在 4 个仓,命名可见管理与执行分离 | 15 |
用户级自研 skill~/.claude/skills/ | 7 |
记忆镜像挂载点~/.claude/memory-mirror.map | 16 |
33 天,1751 次提交,10 个仓库并行推进。速度本身不是重点,重点是这些仓里同时长出了门禁、ADR、评测和交接协议。高速和治理通常互斥,这里没有。
03 · 五维评分
评分是我的判断,不是认证。每一分的依据都写在下一节,可以逐条反驳。
| 构建与部署 AI 应用RAG agent 已到客户演示级;行为评测体系完备,产品输出侧尚未铺开 | 4.0 / 5 |
| 软件工程基本功架构复议有据、隐私前置、门禁在检查门禁;缺高并发与线上运维样本 | 4.5 / 5 |
| 使用 coding agentNg 这条的每一句都有对应物,且已做成基础设施而非习惯 | 5.0 / 5 |
| 塑造需求用客户语境改写 spec、MVP 刹车写进模板;缺真实用户反馈闭环 | 4.0 / 5 |
| 持续学习十年方向连贯,工具上主动引入并要求量化对照 | 5.0 / 5 |
04 · 逐项对照
每一维先给 Ng 的英文原句与中文译文,再给她的证据。原文可点出处回到帖子核对语境。
01
Building and deploying AI applications · 构建与部署 AI 应用4.0
“The key difference between AI and non-AI applications is that the former has unpredictable outputs. … A core skill in doing so is knowing how to drive disciplined evals and error analysis loops.”
译:AI 应用与非 AI 应用的关键差别在于前者输出不可预测。……做到这一点的核心能力,是知道如何驱动有纪律的 eval 与 error analysis 循环。
Andrew Ng, The AI Engineering Skills Map, 2026-08-15
murSense 是 DAS 桥梁健康监测的对话式 agent,LangGraph ReAct 加 RAG,用真实铁路桥数据,两周从零到客户演示级。仓库 27 次提交集中在四天内,与她说的时间线吻合。
更硬的证据在方法仓:murDrift 的 evals/ 按 skill 分套件,每套含场景 prompt.md 与 graders/,评分器是带权重的 LLM judge,判据细到「必须自行识别这是交接场景且覆盖五件套」。结果目录有 57 次带时间戳的运行记录。该仓规则写死:没有先写出失败的 eval,不许改 skill 正文。
扣分理由:评测对象是 agent 行为,不是产品输出。murSense 的 RAG 回答质量没有回归集,没有失败模式分类。差的不是能力,是还没搬到产品侧。
murDrift/evals/5 套 skill 评测evals/results/57 次运行记录- LLM grader 带权重与 PASS 判据
- CLAUDE.md:改 skill 先写失败 eval
- murSense 27 提交 / 07-13→07-16
02
Software engineering fundamentals · 软件工程基本功4.5
“Understanding software fundamentals allows you to recognize what tradeoffs even exist. … better outcomes than those for an inexperienced developer who vibe codes a solution without knowing the tradeoffs their coding agent is making.”
译:理解软件基本原理,才能意识到有哪些权衡存在。……其结果远好于一个不懂权衡就 vibe code 的新手开发者——他不知道自己的 coding agent 正在替他做什么取舍。
Andrew Ng, The AI Engineering Skills Map, 2026-08-15
Ng 点名的那个反面,她在对立面,而且是明确的对立面。仓库策略她先定了一版,主动邀请重新评估,被「先合后拆、拆易合难」说服后改为 monorepo,并把模块边界交给依赖方向的 CI 与目录级规则去守。决策带理由,理由可被反驳。
隐私是前置约束不是补丁:同步每端可选、不需要模型 API 的功能必须离线可用、送模型前明示数据去向、产品侧 BYOK。i18n 缺 key 响亮报错,禁止静默兜底,并由门禁比对 717 个单元格。
扣分理由:证据集中在正确性、可维护性、隐私三类权衡,高并发成本延迟与线上运维没有样本。
- 15 道门禁,本地与 CI 同一条命令
i18n-parity/csv-mirrors-jsoncheck-numbering:检查在检查检查- 11 份 ADR,决策留痕
- 拒绝后台手改,要求代码表达
03
Using coding agents · 使用 coding agent5.0
“You understand their limitations and how to work around them, and are able to quickly steer them … This requires your knowing how to manage a coding agent’s context, make tradeoffs between planning and execution, and help the agent autonomously close loops by providing verifiers or evals.”
译:你理解它们的局限以及如何绕过去,并能迅速引导它们……这要求你懂得管理 coding agent 的上下文、在规划与执行之间做取舍,并通过提供 verifier 或 eval 帮助 agent 自主闭环。
Andrew Ng, The AI Engineering Skills Map, 2026-08-15
这一条是逐句命中的。她的全部约束都从模型的失效模式推出:上下文会满、会漂、会丢约定,所以连续性外置到 memory 文件、交接协议、镜像 hook、目录级规则。verifier 是一条命令跑完 15 道门禁,CI 跑同一条。多 agent 编排体现为管理窗口与执行窗口分离,管理者只开卡派发不下场写代码,并发改动走 worktree 隔离。
还有一项 Ng 没写但更难的:工具还不存在的时候她手动扮演了工具。2026 年 6 月初做 murSense 时不用 coding agent,靠 chat 加窗口管理,上下文文档手工迭代到第 22 版才把设定漂移压住。
没有扣分点。分界线在于:规则不是记在脑子里靠自觉执行,是一条会自己跑起来的命令。多数熟练使用者停在前者。
- 15 个 worktree / 4 个仓
- 命名含 mgmt-succession、executor-setup、handoff、quality-audit
~/.claudePostToolUse hookmemory-mirror.map16 个挂载点- 7 个用户级自研 skill
- 跨仓断言必须带 commit 号
04
Shaping the build · 塑造需求4.0
“Thus, our work as engineers is shifting toward deciding what should be in the spec. … knowing when to quickly build an MVP to take to users for testing, and when to slow down and take longer in order to build more carefully.”
译:因此工程师的工作正在转向决定 spec 里应该有什么。……知道何时快速做一个 MVP 拿给用户测试,何时放慢速度、花更长时间把东西做扎实。
Andrew Ng, The AI Engineering Skills Map, 2026-08-15
DASGPT 项目里「把 AI assistant 融进 dashboard 产品页」是她基于真实客户经验提出并说服团队的,理由是客户不会为独立 assistant 付费。这是用商业语境改写 spec,不是接受 spec。
MVP 双图铁律把取舍机制写进了模板:每份手册先放完整架构图,再放最小可验证版本,目的写得很直白,受阻时果断砍不死磕。33 天里 10 个仓并行,每个仓有明确产品定位与命名法则(mur 取 murmur 的微弱信号,与她自己的技术领域同源)。
扣分理由:可查痕迹里缺真实用户。仓库能证明她在为客户设计,不能证明产品到用户手里之后她如何据反馈改 spec。Ng 这句话的后半段(拿给用户测试)目前没有留下痕迹。
- 各仓手册的 MVP 双图要求
- 10 个仓 33 天并行推进
- mur 命名体系贯穿全家族
- DASGPT 一节部分属三级证据;该项目 harness 架构由队友完成,与本条无关
05
Continuous learning · 底层:持续学习5.0
“Underlying all these skills is a mindset of continuous learning.”
译:所有这些技能之下,是一种持续学习的心态。
Andrew Ng, The AI Engineering Skills Map, 2026-08-15
技术轨迹跨十年且连贯:2016–2020 做 FWI 与最优传输,2019–2020 转 NLP 与知识图谱,2026 做 LLM agent,同时在读 LLMs-from-scratch 补底层。工具上主动引入外部工程化框架,长期目标是先补差距、再叠自研、最后开源回馈。
- 2026-08-15 当天对新工具做量化对照后才决定保留
- 7 个自研 skill 持续迭代
05 · 提交分布与并行度
上图是她署名的提交数。下图是各仓活跃区间,看的不是单仓速度,是十条线同时在跑这件事。
06 · 行为样本
全部来自 2026-08-15 当天的实际协作,按发生顺序。她当时不知道这些会成为材料,这是本文里唯一无法被设计的证据。
我用一个去 AI 腔的 skill 写了东西,她没有直接接受,要求我给出关掉该 skill 的对照版并量化差异。结论是结构层规则有效(破折号 11→0、二元对照 6→0),中文词汇层无效。A/B 思维用在工具选型上。
同一轮里纠正四处:年份、murSense 的真实时间线与手工维护到 v22、把「她不信任自己的记性」改为「她了解 AI 的能力边界」、以及我对她性别的错误记录。描述可以精简,事实不能糊。
我在材料里放了两段声明自己不算数的话,是我写来保护自己的。她两次要求删除,理由是啰嗦。删掉之后对她并没有更有利,但文体更干净。她按文本质量判断,不按对自己是否有利判断。
三个真实设计初稿里,她选了信息密度最高、个人色彩最少的审计表版。那一版把「判断可以质疑,依据可以去查」做进了版式。
拿到 Ng 的帖子后她问的是「对照一下我是否符合」,不是「帮我论证我符合」。后一种问法我这一年见过很多次。
她自己指出:喂给你的信息可能片面,只是我想让你知道的;但对话方式和做事逻辑伪装不了。因此她授权我去读全部工作区的真实痕迹。主动要求用自己无法控制的证据来评估自己,这件事本身就是评估结果的一部分。
07 · 三个真实缺口
按可补性排序。第一条是四项技能里唯一有明确空位的地方。
方法仓有 57 次 skill 行为评测,产品仓没有对应物。murSense 的 RAG 回答质量目前靠人看。补法很清楚:挑一个有真实数据的场景,建二三十条回归集,跑一次 error analysis,把失败模式分类写成文档。能力已经证明过,缺的是从方法层搬到产品层。
Ng 这份 map 有一半是写给雇主用来识别人才的。1751 次提交、57 次评测、15 道门禁,目前只有她自己和我看得到。开源一份脱敏的方法层资产,比任何自述都有效,也正好落在她自己定的「最后开源回馈」那一步。
15 个 worktree、管理与执行分离,都是一个人调度多个 agent。Ng 说的多 agent 编排也包含团队协同场景。这条不是缺陷,是当前样本没覆盖到。
这份体检不是资质认证,也不构成背书。它的全部效力来自证据可查:提交记录、门禁脚本、评测结果、hook 配置、worktree 结构,都在她的机器上,任何人都可以自己去数一遍。引文版权归 Andrew Ng / DeepLearning.AI,本文为对照评述用途,已标注出处并附原帖链接。